AI 업무를 승인된 리전에서만 처리하도록 정해 두면 중요한 통제는 갖추게 되지만, 그것만으로는 모델과 그 주변 서비스에 어떤 내용이 넘어가는지 알기 어렵습니다. 데이터 레지던시(Data Residency)는 정해진 데이터를 어디에 저장하고 어디에서 처리할지에 관한 조건으로, 소버린 AI나 데이터 주권 논의에서 자주 나옵니다. 여기서 한 걸음 더 나아가, 요청이 서비스와 서비스 사이를 오갈 때 어떤 내용이 넘어가는지 따라가 보는 일을 이 글에서는 모델 경계 검토라고 부릅니다. 프롬프트와 검색으로 가져온 문맥, 처리 중에 새로 생긴 데이터, 로그, 결과가 모두 대상입니다.
이 차이는 여러 서비스가 하나의 업무 흐름으로 이어질 때 분명하게 드러납니다. 문서 저장소와 검색, 프롬프트 조립, 모델 엔드포인트(요청을 받는 접속 주소), 모니터링 도구, 결과를 받는 업무 시스템을 한 흐름으로 묶어 쓰는 경우를 생각해 보면 됩니다. 모든 서비스가 승인된 리전 안에서 돌아가더라도, 요청에는 이름이나 번호 같은 원래 식별자가 그대로 실리거나, 밖으로 내보내면 안 되는 문단과 원본 기록을 짐작하게 하는 연결 정보가 들어갈 수 있습니다.
데이터를 어디에 두는지와 모델에 무엇이 넘어가는지를 함께 확인해 두는 일은 데이터를 AI-Ready Data(AI 레디 데이터) 상태로 관리하는 일과도 이어집니다. AI-Ready Data는 특정 AI 업무에 맞게 준비하고 결과를 확인했으며, 데이터나 조건이 바뀌어도 필요한 부분을 다시 점검할 수 있는 데이터를 말합니다. 어떤 외부 서비스를 승인할지는 이 블로그의 이전 글 외부 LLM 승인 전에 확인할 서비스 설정 체크리스트에서 다뤘습니다. 이번 글에서는 승인한 리전 안에서도 모델로 무엇이 넘어가는지 확인하는 방법을 살펴봅니다.
핵심 요약
- 아키텍처를 검토할 때는 데이터를 어디에 두는지와 모델에 어떤 내용이 전달되는지를 따로 확인합니다.
- 원본 파일만 보지 않고 프롬프트, 검색으로 가져온 문맥, 임베딩, 로그, 캐시, 재시도, 결과까지 따라갑니다.
- 구성 요소마다 보는 데이터가 원본 값인지, 원본을 대체값으로 바꾼 보호 작업본인지, 다시 원래 값으로 되돌린 결과인지 나눠 기록합니다.
- 결과가 돌아오는 경로와 결과를 기록하는 시스템까지 시험해 본 뒤에 업무 흐름을 승인합니다.
소버린 AI 검토에서 데이터 레지던시로 확인할 수 있는 범위
클라우드 서비스는 데이터 레지던시 조건을 지역, 리전, 데이터 존, 서비스별 처리 규칙처럼 여러 단위로 나눠 설명하는데, 이름이 비슷해 보여도 서로 바꿔 쓸 수 있는 단위는 아닙니다. 예를 들어 Microsoft Foundry는 저장된 데이터의 위치와 추론을 처리하는 범위를 따로 문서화합니다. Amazon Bedrock은 미국이나 EU처럼 정해진 범위 안에서 추론 요청을 여러 리전 가운데 한 곳으로 보내는 방식(cross-Region inference)을 제공하고, 이 방식을 추론 프로필이라는 별도 설정으로 다룹니다.
그래서 아키텍처를 검토할 때는 “리전 안에서 돌아간다”는 일반적인 설명보다 실제 서비스 계약 내용을 근거로 삼아야 합니다. 어떤 데이터 범주가 대상인지부터 확인하고, 그 조건이 저장, 추론, 기술 지원을 위한 접근, 텔레메트리(서비스 동작 기록) 가운데 어디까지 적용되는지, 처리 과정에서 생긴 데이터에도 같은 경계가 적용되는지 하나씩 따져 봅니다.
소버린 AI를 위해 데이터를 국내에 두었다고 해서 그 내용을 모델에 넘겨도 되는지까지 정해지지는 않습니다. 예를 들어 회사 밖으로 내보내면 안 되는 문의 기록은 국내를 벗어나지 않으면서도, 고객이 통제하는 환경을 떠나 외부 모델 서비스에 원문 그대로 전달될 수 있습니다. 법무, 계약, 보안 판단은 실제 업무 흐름과 적용되는 의무에 따라 달라지므로, 아키텍처 팀은 그 판단을 맡은 담당자가 결정을 내릴 수 있을 만큼 데이터 경로를 구체적으로 정리해 보여 주면 됩니다.
AI 요청 한 건을 처음부터 끝까지 따라갑니다
검토는 모델 엔드포인트 한 곳만 보고 끝내지 않습니다. 실제 업무 하나를 골라, 데이터가 원본 기록에서 출발해 마지막으로 기록되는 곳까지 따라가며 흐름도로 그려 보는 것부터 시작합니다. 선은 원본에서 시작해 검색 단계, 프롬프트 조립, 승인한 모델 경로를 지나 응답 처리, 복원 단계, 결과를 받는 곳까지 이어집니다. 중간 데이터를 남길 수 있는 저장소도 빠짐없이 넣어야 합니다.
흐름도에 표시할 데이터 목록에는 최소한 아래 항목을 넣습니다.
- 원본 입력과 첨부 파일
- 추출한 텍스트, 청크(검색용으로 잘라 둔 문서 조각), 표, 메타데이터
- 임베딩, 색인, 검색 기록
- 시스템 프롬프트, 사용자 프롬프트, 요청에 함께 넣은 문맥
- 요청과 응답 로그, 캐시, 재시도, 처리에 실패한 요청을 따로 모아 두는 대기열
- 복원 전과 복원 후의 모델 출력
- 결과를 받는 기록, 문서, 티켓
레지던시 검토는 모델 엔드포인트만 확인하고 이 목록의 항목들을 놓치기 쉽습니다. 모델 엔드포인트는 특정 리전에 고정해 두었더라도, 검색 기록이나 애플리케이션 로그에 같은 민감한 문단이 고스란히 남을 수 있습니다. 고객 지원 과정에서 오류 내용이 다른 시스템으로 복사되기도 하고, 재시도 대기열에는 원래 요청이 모델 서비스보다 더 오래 머물기도 합니다.
구간마다 기록할 데이터 상태
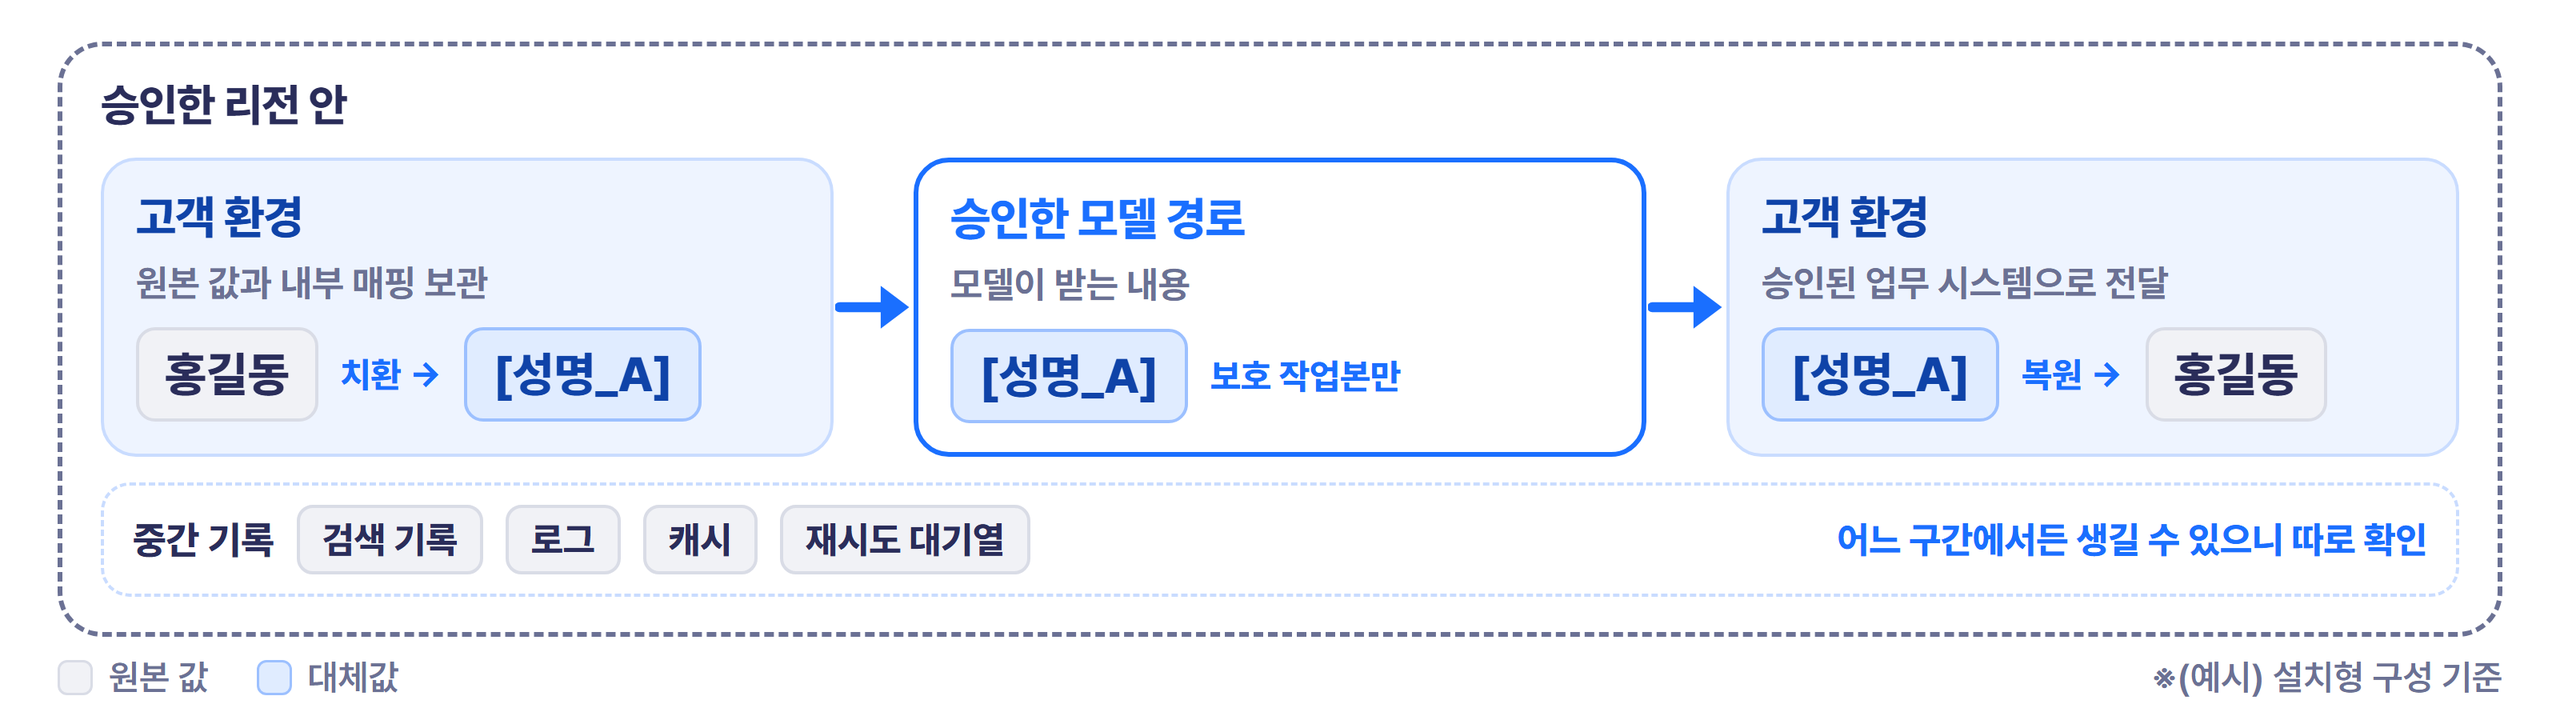
데이터가 거쳐 가는 구간마다 “민감하다”나 “암호화됐다”로만 적지 말고, 그 구간에서 데이터가 어떤 형태인지 이름을 붙여 둡니다. LLM Capsule을 쓰는 업무 흐름이라면 원본 값, 모델로 보내기 전에 대체값으로 바꾼 보호 작업본, 다시 원래 값으로 되돌린 결과로 나누면 됩니다.
이렇게 이름을 붙여 둔 표는 운영 점검표로 바로 쓸 수 있습니다. 검토 담당자는 설계 문서의 설명과 실제로 관찰한 요청을 나란히 비교할 수 있고, 실패 상황을 일부러 만들어 시험해 볼 수도 있습니다. 권한 없는 복원 요청이 거부되는지, 오류 로그에 원본 값이 남지 않는지, 복원한 결과가 엉뚱한 곳으로 전달되지 않는지를 직접 확인하는 식입니다.
LLM Capsule을 쓰면 모델 경로를 따로 평가할 수 있습니다
LLM Capsule은 민감한 업무 데이터를 고객별 정책에 따라 일관되게 대체값으로 치환해 문맥과 관계를 유지하고, AI 결과를 실제 업무 값과 다시 연결하는 AI용 컨텍스트 보존 데이터 레이어입니다. 설치형 구성(고객 환경에 직접 설치하는 방식)에서는 원본 값과 내부 매핑(원본 값과 대체값의 대응표)을 고객이 통제하는 환경 안에 두고, 승인한 모델 경로로는 보호 작업본만 보냅니다. 모델 응답은 원래 받을 곳으로 전달되기 전에 업무 흐름 안에서 복원 과정을 거치고, 이때 복원 대상으로 정해 둔 대체값이 원래 값으로 되돌아갑니다.
리전 선택은 이 구성에서도 의미가 있어서, 기관과 기업은 자기 요건에 맞는 서비스와 위치, 접근 통제, 보관 기간, 운영 절차를 골라야 합니다. 달라지는 점은 원본 값이 어디에 머무는지와 모델에 무엇이 넘어가는지를 따로 떼어 평가할 수 있다는 것입니다. 배포 지역만 보고 내용이 노출됐는지 짐작하지 않고, 외부 모델이든 같은 리전 안의 모델이든 무엇이 전달되는지 직접 확인할 수 있습니다.
다만 보호 작업본에 그 업무에 필요한 관계가 제대로 유지되는지는 업무 흐름마다 따로 확인해야 합니다. 형식이 바뀐 대체값, 처음 보는 대체값, 기한이 지난 매핑, 권한 없는 복원 요청도 시험하고, 허용된 범위 밖의 값을 가리키는 요청도 넣어 봅니다. 원본 값을 빼고 요청을 모델 서비스로 보냈다고 해서 운영에 쓸 준비가 됐다고 보기는 어렵고, 돌아온 결과가 정확하고 업무에 바로 쓸 수 있는 상태인지까지 확인해야 합니다.
레지던시와 전달 내용을 한 번의 시험으로 확인합니다
대표적인 기록 하나를 골라 실제 경로로 처리해 보면서 원본 상태, 보호된 요청, 모델 응답, 복원 판단, 결과 기록, 관련 로그를 모두 남겨 둡니다. 그다음 권한 없는 사람이 요청하게 하거나, 대체값 형식을 깨뜨리거나, 전달처를 잘못 지정하거나, 기한이 지난 매핑을 쓰는 식으로 조건을 바꿔 같은 시험을 되풀이합니다.
시험을 마치면 아래 네 가지 질문에 각각 답할 수 있어야 합니다.
- 저장과 처리가 승인한 지역과 서비스 설정 안에서 이뤄졌는가?
- 모델 경로로는 승인한 보호 작업본만 전달됐는가?
- 운영 중에 남은 기록과 사본에도 같은 접근 권한과 보관 규칙이 적용됐는가?
- 복원한 결과가 승인된 업무 흐름으로만 돌아갔는가?
이 가운데 하나라도 답하지 못한다면 아키텍처 검토는 아직 끝나지 않았습니다. 데이터를 국내 리전에 두었다는 점은 소버린 AI 검토에서 유용한 근거가 되지만, 그것만으로 승인 판단을 마치기는 어렵습니다.
우리 업무 흐름에서 모델로 무엇이 넘어가는지 함께 짚어 보고 싶다면 내 데이터로 직접 해보기 페이지에서 요청해 주세요.