망분리 환경의 공공기관이나 금융사가 외부로 반출할 수 없는 계약서와 내부 보고서를 RAG(검색 증강 생성)에 활용하려면, 먼저 그 문서를 AI-Ready Data(AI 레디 데이터) 상태로 준비해야 합니다. 여기서 AI-Ready Data는 쓰려는 AI 업무와 모델에 맞게 준비되어 있고, 데이터나 모델 같은 조건이 바뀐 뒤에도 다시 검증할 수 있는 데이터 상태를 말합니다. 반출할 수 없는 문서는 둘 수 있는 곳이 정해져 있으므로, 이 상태를 만드는 첫걸음은 RAG 단계마다 원문이 어디까지 가도 되는지 정하는 일입니다.
RAG를 거치는 동안 계약서 조항 하나가 모습을 바꿔 가며 여러 곳에 남을 수 있습니다. 추출한 텍스트, 잘게 나눈 조각(청크), 메타데이터, 검색용 숫자 벡터(임베딩), 검색 결과, 답변 속 인용, 로그가 모두 그런 형태입니다. 그래서 문서를 찾아 답변을 만드는 경로 전체를 단계로 나눠 봅니다. 임베딩을 저장하는 벡터 데이터베이스에도 원문에서 나온 데이터가 남으므로, 이것도 따라갈 경로에 포함합니다. 그리고 단계마다 데이터가 놓여도 되는 곳과 그 데이터를 읽어도 되는 사람이나 시스템을 정해 선을 긋습니다. 이 글에서는 이 선을 경계라고 부릅니다.
열람 권한이 있는 기관 계약 담당자가 내부망에 보관된 용역 계약서 두 건의 계약 해지 조항을 비교한다고 가정해 보겠습니다. 시스템은 두 계약서에서 맞는 조항을 찾아야 합니다. 이때 계약서에 적힌 대표자 성명 같은 원본 값은 승인받지 않은 모델로 넘어가면 안 됩니다. 승인된 모델이라고 해서 원본 값을 그대로 넘겨도 되는 것도 아니며, 무엇을 넘길지는 기관이 정합니다. 답변에는 질문한 계약 담당자가 원문과 대조할 수 있도록 출처 정보를 남깁니다. 완성된 답변은 승인된 업무 시스템으로만 보내 그곳에 남기고, 담당자는 그 업무 화면에서 답변을 봅니다. 조항 검색, 모델로 보낼 값 정하기, 출처 기록, 답변 전달은 각각 다른 단계에서 일어나므로 경계도 단계마다 따로 둡니다.
핵심 요약
- RAG를 단계별로 나눠, 단계마다 데이터가 놓이는 곳과 그 데이터를 읽는 사람이나 시스템을 확인합니다.
- 모델로 보내기 전에 원본 값을 표식으로 바꾼 글(작업본)을 만들고, 같은 값은 같은 표식으로 바꿔 문장 속 관계를 살립니다.
- 답변의 인용을 따라가면 원본 문서의 해당 위치로 돌아갈 수 있도록, 원본 문서부터 답변까지 같은 참조 번호를 끊기지 않게 유지합니다.
- 실패 상황도 미리 시험합니다. 권한 없는 조항이 검색 후보에 오를 때, 대응표(매핑 정보)에 없는 표식이 답변에 나올 때, 색인에 오래된 항목이 남아 있을 때, 프롬프트 기록이나 검색 기록에 치환 전 원문이 저장될 때, 완성된 답변을 업무 시스템에 남기는 마지막 단계가 실패할 때입니다.
이 블로그의 이전 글 직접 만든 AI 에이전트를 기관 DMZ에서 쓰기 전 확인할 기준에서는 업무 에이전트의 요청이 승인된 모델로 가기 전에 기관 DMZ에서 민감한 값을 표식으로 바꾸는(치환) 구성을 다뤘습니다. RAG에는 그보다 앞에 문서를 모으고(수집), 찾기 쉽게 정리하고(색인), 찾는(검색) 단계가 더 있고, 답변에 출처를 남기는 일도 더해집니다.
RAG 단계마다 원문이 남는 곳이 다릅니다
2020년 NeurIPS(신경정보처리시스템학회)에 발표된 RAG 원 논문(Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks)은 학습으로 익힌 모델의 지식과 외부 색인에서 찾은 문단을 함께 써서 답을 만드는 구조를 제시했습니다. 실제 운영에서는 단계가 더 잘게 나뉩니다. 앞의 계약서 조항은 텍스트 추출, 청크 분할, 색인, 검색과 재정렬(검색 결과의 순서를 다시 매기는 일), 프롬프트 조립, 모델 추론, 출력 처리 같은 단계를 거쳐 업무 화면의 답변이 됩니다.
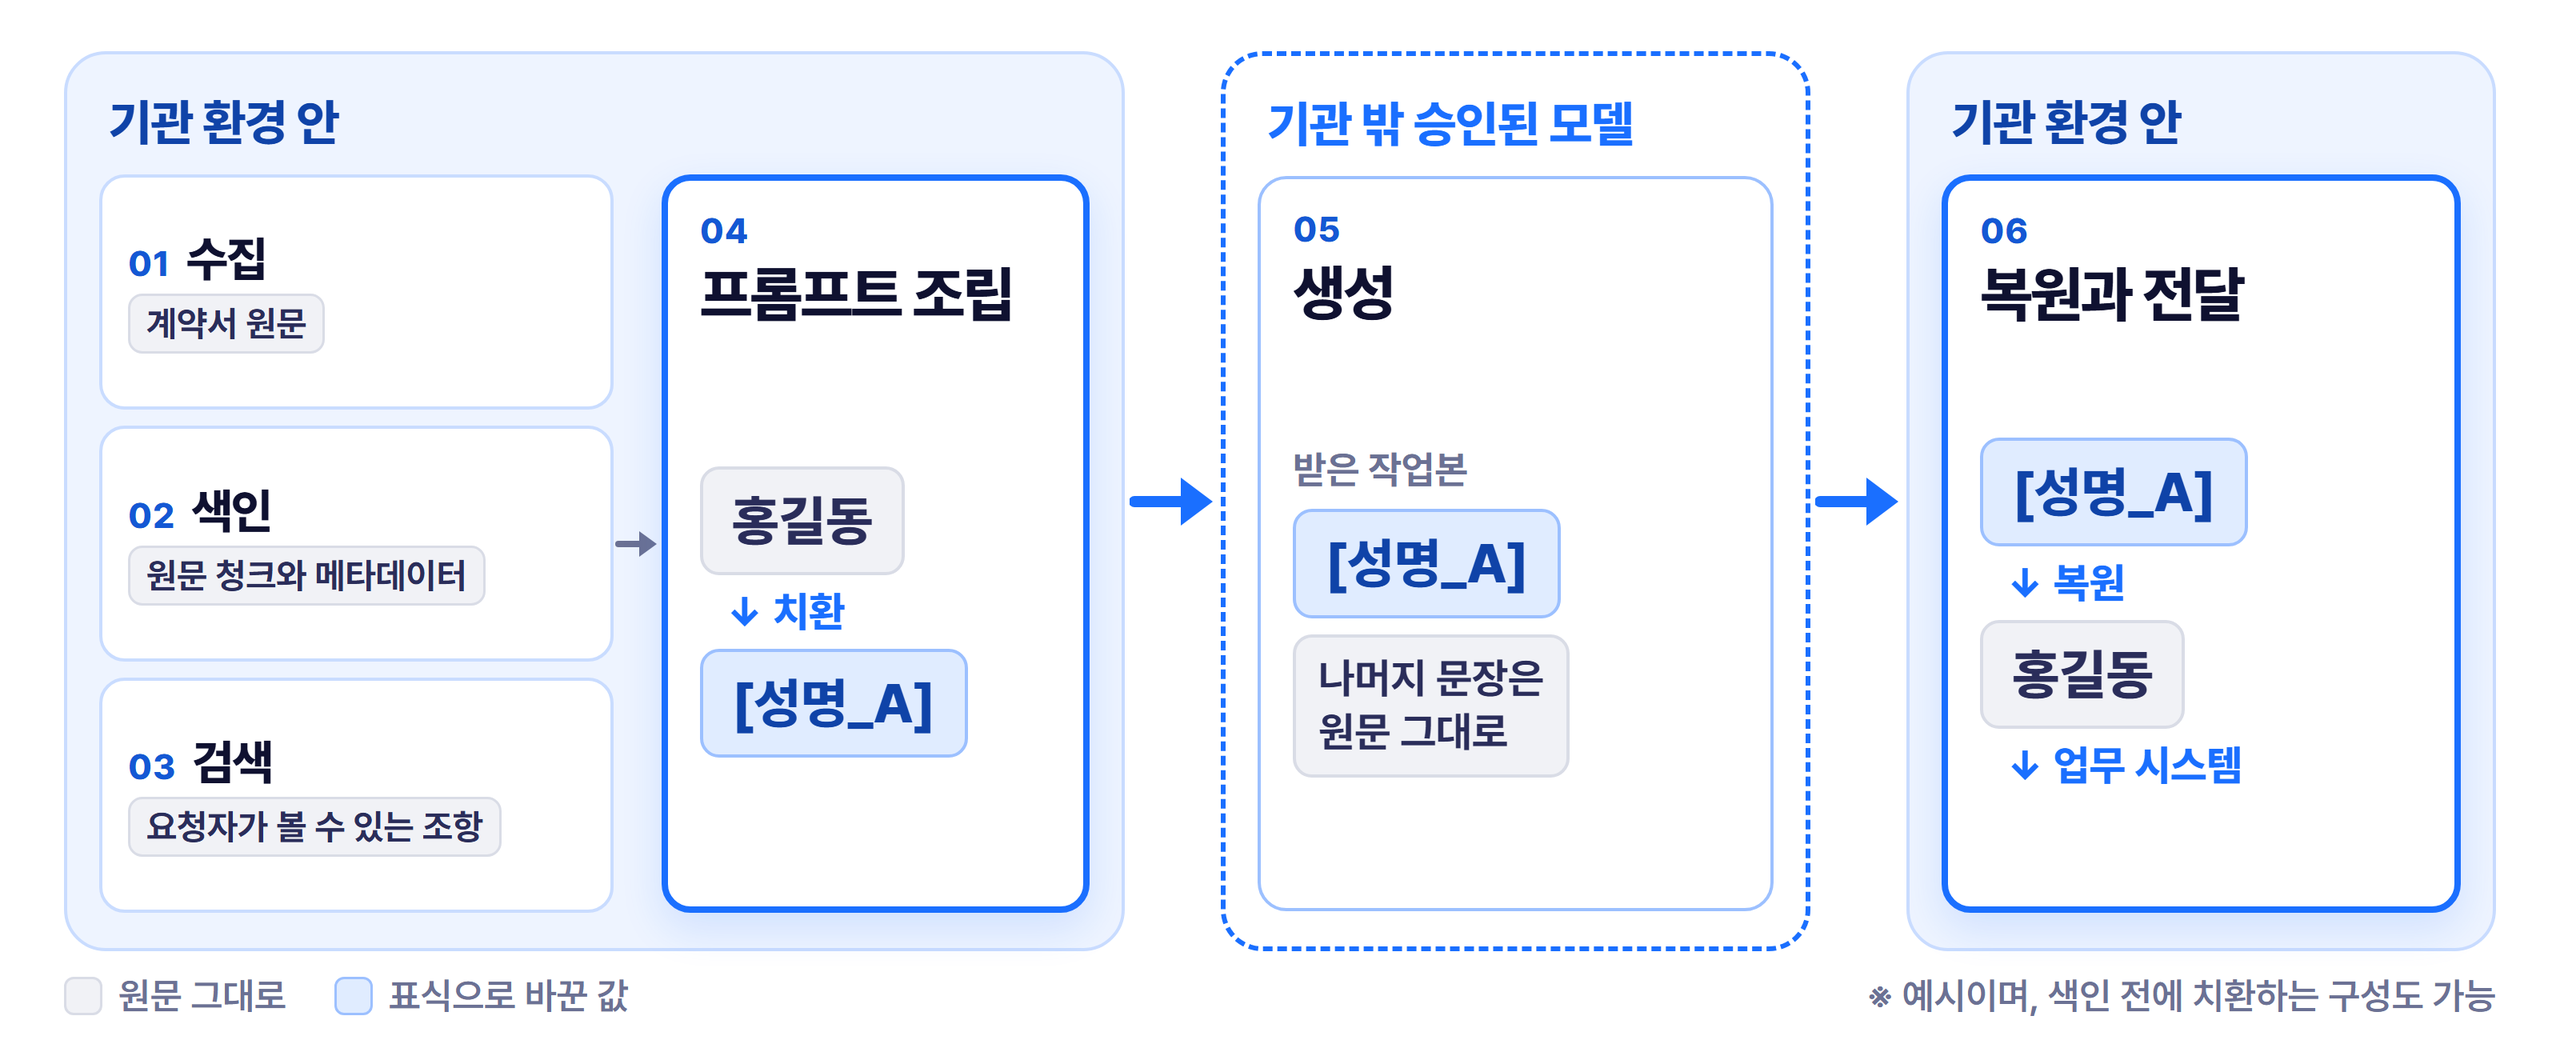
이 글에서는 이 단계들을 여섯 가지로 묶습니다. 문서를 가져와 텍스트를 추출하는 단계는 「수집」, 청크 분할과 색인은 「색인」, 검색과 재정렬은 「검색」, 프롬프트 조립은 그대로 「프롬프트 조립」, 모델 추론은 「생성」입니다. 마지막 출력 처리에 표식을 원본 값으로 되돌리는 일과 답변을 업무 시스템으로 보내는 일을 더한 것이 「복원과 전달」입니다. 아래 그림과 글 끝의 표도 이 여섯 단계를 씁니다.
원문 정보는 이 가운데 어느 단계에서든 드러날 수 있습니다. 청크에 계약명이 그대로 반복되기도 하고, 메타데이터에 계약상대자나 사업명이 남기도 합니다. 임베딩은 숫자로 바뀌었어도 원문에서 만든 데이터입니다. 그러니 시스템이 다루는 데이터를 정리한 목록에 임베딩도 넣고, 원문 문서와 같은 수준으로 관리할지 미리 정해 둡니다. 담당 부서나 계약 종류처럼 기관이 하나씩은 내보내도 된다고 정한 항목도 있습니다. 하지만 이런 항목이 프롬프트 한곳에 함께 담기면, 합쳐서 어느 계약인지 알아볼 수 있는 민감한 정보가 될 수 있습니다. 검색 기록, 답변에 들어간 인용문, 캐시, 로그도 함께 점검합니다.
계약서 조항 하나를 골라 원본 문서에서 사용자가 보는 답변까지 따라가며, 그 조항을 저장하거나 바꾸거나 읽는 구성 요소를 하나씩 적어 보세요. 적어 보면 색인에 남긴 내용이 검색 결과를 거쳐 프롬프트의 재료가 된다는 점이 보입니다. 색인에 한번 넣은 내용은 대개 문서를 다시 색인해야 바꿀 수 있으니, 색인에 무엇을 남길지는 색인을 만들기 전에 정해 둡니다.
아래 그림은 수집, 색인, 검색까지는 기관 안에서 원문 그대로 처리하고, 모델로 보내기 직전(프롬프트 조립)에 원본 값을 표식으로 바꾼 작업본을 만드는 구성의 예입니다. 그림은 승인된 모델이 기관 밖에 있는 경우입니다. 이때 표식으로 바뀌는 것은 성명 같은 치환 대상뿐이고, 나머지 조항 문장은 원문 그대로 기관 밖 모델로 갑니다. 그래서 반출할 수 없는 문서라면 조항 문장까지 포함해 모델에 무엇을 넘길지를 기관의 승인 범위로 먼저 정해야 하며, 기관 안에 둔 모델을 승인받아 쓰는 구성도 있습니다.
색인에 남길 내용부터 정합니다
앞의 계약서 업무라면 색인에 둘 수 있는 것은 원문 조항, 치환한 텍스트, 문서를 다시 찾게 해 주는 참조 번호입니다. 하나만 두거나 여러 가지를 함께 둘 수 있고, 원문 조항을 두는 색인은 기관 안에서만 씁니다. 다만 기관 안이라 해도 원문 조항을 색인에 넣어도 되는지는 경우마다 다릅니다. 시스템을 어디에 두고 어디까지 연결하는지(배포 경계), 누가 무엇을 볼 수 있는지(접근 권한), 검색을 어떻게 설계했는지, 기관이 따라야 하는 규정이 무엇인지가 판단 기준입니다.
문서 분류마다 다음을 정해 둡니다.
- 텍스트 추출과 청크 분할을 실행할 위치
- 색인에 저장할 것(원문, 치환한 텍스트, 참조 번호)
- 검색할 때 조건으로 쓸 수 있도록 열어 둘 메타데이터 항목
- 문서가 개정돼도 문서 번호와 청크 번호가 유지되는지(답변의 출처를 다시 찾을 때 필요)
- 문서 범위별 검색 권한
- 문서를 지우거나 다시 색인했을 때 그 변경이 색인과 임베딩까지 반영되는지
- 위 설정대로 실제로 동작하는지 보여 줄 근거
색인하기 전에 문서를 치환해 두면 밖으로 드러나는 정보는 줄어듭니다. 하지만 검색할 때 문서를 서로 구별해 주던 정보까지 사라지면 관련 조항을 찾는 정확도가 떨어질 수 있습니다. 업무 질문마다 찾아야 할 조항을 미리 정해 두고, 같은 질문을 기관 안의 원문 색인과 치환한 색인에 각각 넣어 둘 다 그 조항을 찾는지 견줘 보면 차이를 확인할 수 있습니다. 이 시험에는 실제 운영에서 쓸 치환 방식과 문서 묶음, 업무 질문을 그대로 씁니다.
모델로 보내기 전에 작업본을 만듭니다
요청한 사람이 어떤 조항까지 검색할 수 있는지와, 검색된 조항을 어떤 형태로 바꿔 승인된 모델에 보낼지는 서로 다른 결정입니다. 검색 권한을 나누는 방법은 마이크로소프트(Microsoft)의 멀티테넌트 RAG 설계 지침(Design a secure multitenant RAG inferencing solution)에 나옵니다. 여러 고객사나 조직이 RAG 시스템 하나를 함께 쓰는 경우를 다룬 문서지만 같은 조직 안의 사용자별 권한도 다룹니다. 이 지침에 따르면 요청에 사용자의 신원과 접근 권한 정보를 실어 검색 단계까지 넘기고, 그 사용자가 볼 수 있는 데이터만 답변 근거로 씁니다. 앞의 계약서 예라면 요청자가 볼 수 있는 조항을 검색기가 고르고, 그 조항은 모델로 보내기 전에 작업본으로 바뀝니다. 이렇게 검색 권한은 검색기에서, 치환은 작업본을 만들 때 따로 다루므로 누가 무엇을 검색할 수 있는지와 모델에 무엇을 넘기는지를 각각 관리할 수 있습니다.
작업본을 만드는 제품 가운데 하나로 LLM Capsule이 있습니다. LLM Capsule은 AI를 위한 컨텍스트 보존 데이터 레이어입니다. 민감한 값을 표식으로 바꾸되 문장 속 관계는 살려 AI 업무에 활용할 수 있게 하고, 답변이 나오면 표식을 원본 값으로 되돌립니다. LLM Capsule을 기관 안에 설치해 쓰면, 표식으로 바꾼 원본 값과 매핑 정보(어떤 값을 어떤 표식으로 바꿨는지 적은 대응표)는 기관 안에 보관됩니다. 다른 배포 형태라면 처리 위치가 달라질 수 있으니 따로 확인이 필요합니다. 승인된 모델로는 민감한 값을 [성명_A]처럼 유형이 붙은 표식으로 바꾼 작업본이 갑니다. 한 요청 안에서는 같은 값을 같은 표식으로 바꿉니다. 그래서 문서 두 곳에 같은 이름이 나오면 둘 다 [성명_A]가 되고, 작업본에서도 두 이름이 같은 사람이라는 관계가 유지됩니다.
다만 모델로 가는 작업본에서 표식으로 바뀌는 것은 치환 대상인 값뿐이고, 그 밖의 조항 문장은 원문 그대로 담겨 전달됩니다. 그래서 조항 문장을 포함해 어떤 모델에 무엇을 보낼지는 기관의 승인 절차와 규정으로 먼저 정합니다. LLM Capsule을 도입했다고 외부 모델 이용이 허용되지는 않습니다. 치환 대상이 빠짐없이 탐지된다고 보장할 수도 없으므로, 실제 계약서로 작업본 샘플을 만들어 원본 값이 남지 않았는지 점검합니다. 비교에 직접 쓰는 금액이나 날짜가 표식으로 바뀌면 값을 견주기 어려우니, 그런 값이 작업본에 어떤 형태로 들어가는지도 함께 봅니다.
치환하는 위치는 배포마다 다릅니다. 색인하기 전에 문서를 치환하는 구성도 있고, 기관 안에서 원문으로 색인한 뒤 검색된 조항만 프롬프트 조립 직전에 치환하는 구성도 있습니다. 제품을 도입한다고 이 선택이 저절로 정해지지는 않으니, 어느 쪽을 골랐는지 기록해 두고 실제 배포 경로에서 시험해 봅니다. 지금 운영 중인 RAG 파이프라인에 LLM Capsule을 함께 쓸 수 있는지, 쓴다면 어느 단계에 둘지는 도입 전에 배포 환경별로 확인할 일입니다.
출처와 복원 범위를 정해 둡니다
답변을 검토하는 사람은 출처를 보고 답변이 맞는지 확인할 수 있어야 합니다. 그렇다고 답변에 출처를 달려고 원문 제목, 저장 경로, 원문 발췌를 작업본과 별도로 모델에 더 보낼 필요는 없습니다. 인용 규칙은 출처를 정확히 가리키되 모델로 넘어가는 정보는 줄이는 쪽으로 미리 세워 둡니다.
예를 들어 답변을 만드는 동안 모델에는 조항마다 문서 참조 번호, 버전, 쪽이나 절 위치, 청크 번호를 함께 넘깁니다. 이 참조 번호는 실제 계약번호나 문서번호가 아니라 이 시스템 안에서만 쓰는 번호입니다. 원문 제목이나 저장 경로는 프롬프트에 넣지 않고, 업무 화면에서 권한을 확인한 다음에 참조 번호를 실제 문서로 이어 줍니다. 이 방식이 제대로 동작하는지는 네 가지 경우로 시험합니다. 같은 문서를 여러 번 인용한 경우, 절 위치가 옮겨진 경우, 문서가 삭제된 경우, 답변이 검색 결과에 없던 청크를 출처로 단 경우입니다.
답변이 생성된 뒤에는 기관 안에 둔 매핑 정보로 표식을 원본 값으로 되돌리는데, 이 과정을 복원(Reconstruction)이라고 합니다. 복원할 대상도 미리 한정합니다. 원본 값으로 되돌리는 것은 매핑 정보에 실제로 있는 표식뿐입니다. 표식처럼 생긴 글자가 답변에 나와도 매핑 정보에 없는 것이면, 무엇을 가리키는지 짐작해 원본 값을 채워 넣지 않습니다. 알 수 없거나 형식이 바뀐 표식은 그대로 드러나게 둔 채 검토 절차나 실패 처리로 보냅니다. 복원한 결과를 어디에 보내고 누가 볼 수 있는지는 기관의 업무 시스템과 권한 설정에 따릅니다.
검색 실패와 전달 실패를 함께 시험합니다
검색 단계의 권한 필터가 제대로 거르는지 보려면, 시험에 이런 경우를 일부러 넣습니다. 질문에 가장 잘 맞는 조항이 검색 후보에 올라왔는데, 요청한 사람에게는 그 조항을 볼 권한이 없는 경우입니다. 그 조항이 들어가면 정확한 답이 나오더라도 권한 범위를 벗어난 답이 되므로, 그 조항은 프롬프트에 넣지 않고 이 요청은 실패로 처리해야 합니다. 마지막 전달 단계에서도 문제가 생길 수 있습니다. 검색과 생성은 통과했는데, 답변을 받아 저장해야 할 업무 시스템이 저장을 거부하는 경우입니다. 검색만 따로 시험하면 마지막 기록 단계의 실패를 놓치므로, 운영 전 시험은 질문부터 기록까지 한 흐름으로 돌려 확인합니다.
정상 조건과 실패 조건을 함께 넣어 시험합니다.
- 권한이 있는 사람이 질문해 관련 문서 여러 건에서 근거를 찾을 때
- 후보 문서 가운데 하나에 요청자의 열람 권한이 없을 때
- 색인에 오래된 항목이나 일부만 지워진 항목이 남아 있을 때
- 답변에 형식이 바뀌었거나 알 수 없는 표식이 들어갔을 때
- 시스템이 프롬프트나 검색 기록을 남기면서 원문까지 그대로 저장하려 할 때
- 검색 결과 밖의 내용이 답변에 인용됐을 때
- 복원은 됐지만 결과를 기록하는 단계에서 시간 초과나 중복 기록, 거부가 생겼을 때
미국 국립표준기술연구소(National Institute of Standards and Technology, NIST)의 생성형 AI 프로파일(NIST AI 600-1, Generative Artificial Intelligence Profile)은 RAG를 적용한 뒤 모델 위험을 다시 평가하고, 배포 전 시험과 운영 중 점검에서 답변의 출처와 인용을 검토하도록 제안합니다. 시험 기록은 질문 하나마다 다음 내용을 한 묶음으로 이어서 남깁니다. 어떤 검색 설정을 썼는지, 어떤 정책을 적용했는지(정책 버전 포함), 작업본을 어느 경로로 어느 모델에 보냈는지, 그리고 작업본, 답변, 복원 결과, 최종 전달 내역입니다. 그래야 답변의 출처는 물론 문제가 어느 단계에서 생겼는지도 거슬러 찾을 수 있습니다. 이 기록 항목들은 NIST 문서에 나온 목록은 아니고, 앞의 시험 조건에 맞춰 이 글에서 권하는 구성입니다.
운영 승인은 시험한 범위만큼만 받습니다
운영 승인을 받을 때는 먼저 승인 범위를 정리합니다. 대상 문서 분류와 AI로 처리할 문서 업무, 쓸 수 있는 사람과 질문 유형, 승인된 모델 경로, 인용 방식, 복원 범위, 결과를 보낼 곳이 여기에 들어가고, 표식을 복원하지 못했거나 마지막 기록이 실패했을 때의 처리 방법도 포함합니다. 그리고 승인 기록에는 아래 표처럼 단계마다 확인할 질문과 그 질문에 답하는 근거를 함께 남깁니다.
시험하지 않은 문서나 사용자, 질문 유형, 결과를 보낼 곳까지 쓰려면 시험한 범위를 벗어나므로, 승인 검토 절차를 다시 거칩니다. 문서 분류나 치환 정책, 모델 경로가 바뀌면 같은 시험을 다시 돌린 뒤 승인 범위를 고칩니다. 그래야 운영 담당자는 어디까지 운영해도 되는지 분명히 알고, 검토 담당자는 시험으로 모은 근거를 단계별로 보고 판단할 수 있습니다. 처음에 AI-Ready Data를 조건이 바뀐 뒤에도 다시 검증할 수 있는 상태라고 했는데, 이렇게 시험을 다시 돌려 승인 범위를 고치는 과정이 있어야 그 상태가 이 RAG 업무에서 유지됩니다.
가지고 계신 업무 문서로 치환과 복원이 어떻게 동작하는지 보고 싶다면 내 데이터로 직접 해보기 페이지에서 요청하세요. 첫 상담 뒤 LLM Capsule을 기관 환경에 배포하고 그 안에서 문서를 넣어 보는 방식이며, 결과 검토까지 보통 2~4주가 걸립니다. LLM Capsule이 기관 환경 어디에 놓이고 무엇이 경계를 넘는지 먼저 짚어 보려면 같은 페이지에서 아키텍처 리뷰를 고르면 됩니다.